
AITECH TIMES
世界のAIニュースを、要点で。
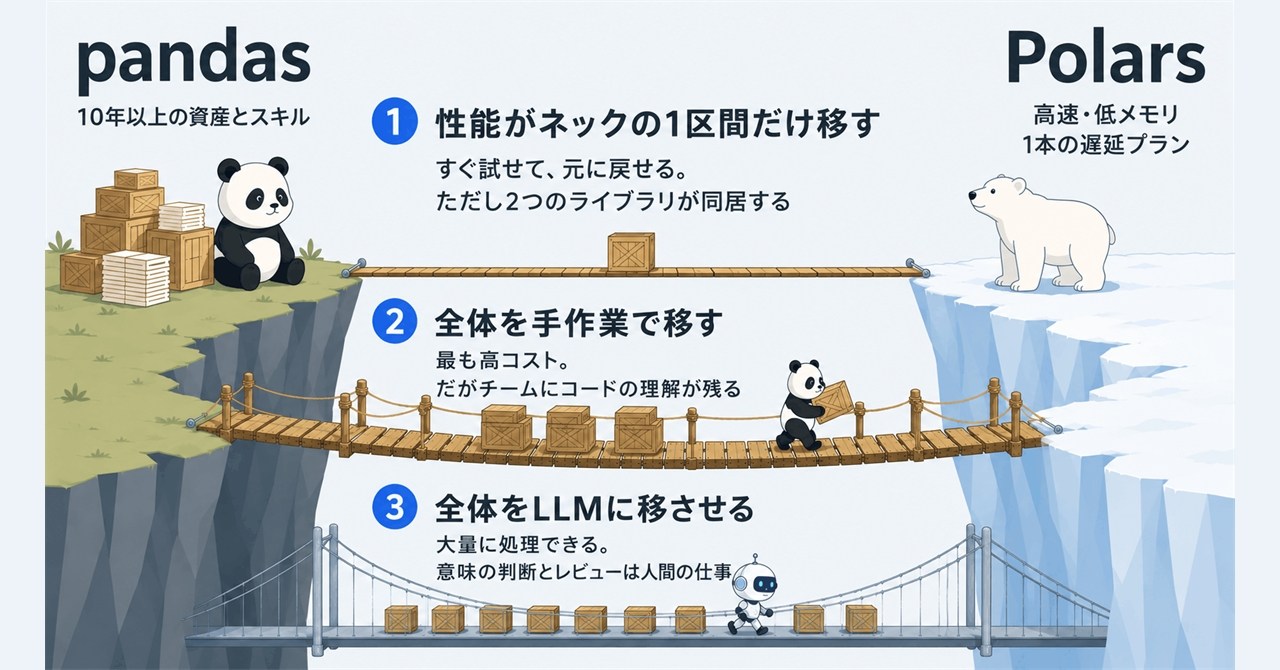
Python向けデータ処理ライブラリのPolarsは、pandasからの移行で「全部書き換えるな」とする考えを示しました。公開された記事では、移行戦略を3つに整理し、段階的にコードを移していく方法を解説しています。背景には、既存の業務ではpandasで書かれたコードがすでに多く、急に全面移行する現実性は高くないという見方があります。
Polars公式の見解では、移行の判断軸は「Polarsらしさ」そのものではなく、保守しやすさや性能面の必要性にあります。まずはpandasで組まれた処理を壊さず、少しずつPolarsへ寄せるほうが、変更管理の負担を抑えやすいとしています。
記事で示された3戦略は、処理を1区間ずつ移す方法、全体を一気に移す方法、LLMに任せる方法です。Polars公式は、全面書き換えを前提にせず、段階移行を基本に据えています。特に、入力と出力の境目を保ちながら、内部だけをPolars化する考え方が紹介されています。
また、具体例としては、pandasからPolarsへ変換し、lazy()で処理をまとめ、最後にcollect()してpandasへ戻す流れが説明されています。Apache Arrowを使うことで、両ライブラリ間の変換コストを抑えやすい点も触れられています。AIを使った移行は有効な場面もありますが、Polars公式は、まず既存のpandasコードを起点に考えるべきだとしています。
記事では、AIの登場でコード生成や書き換えは以前より容易になった一方、移行の設計そのものは別問題だと整理しています。Polars公式は、AIであっても一度に全てを置き換えるより、既存資産を活かしながら段階的に移行するほうが現実的だと示しています。
そのうえで、移行の目的は「Polarsを使うこと」ではなく、「適切な部分でPolarsを使える状態にすること」だと読めます。無理に全面移行を急ぐのではなく、必要な箇所から置き換えていく姿勢が重要だと伝えています。

